从高难度问题到可复核的模型证据
以下案例覆盖 STEM、金融、法律、医学、Agent、机器学习、软件工程、地学与教育。从任务目标、执行过程到参考产物与验收方法,查看完整交付结构。
工作台为对应领域的界面设计示意;进入案例可查看交付方法与原有流程视频。
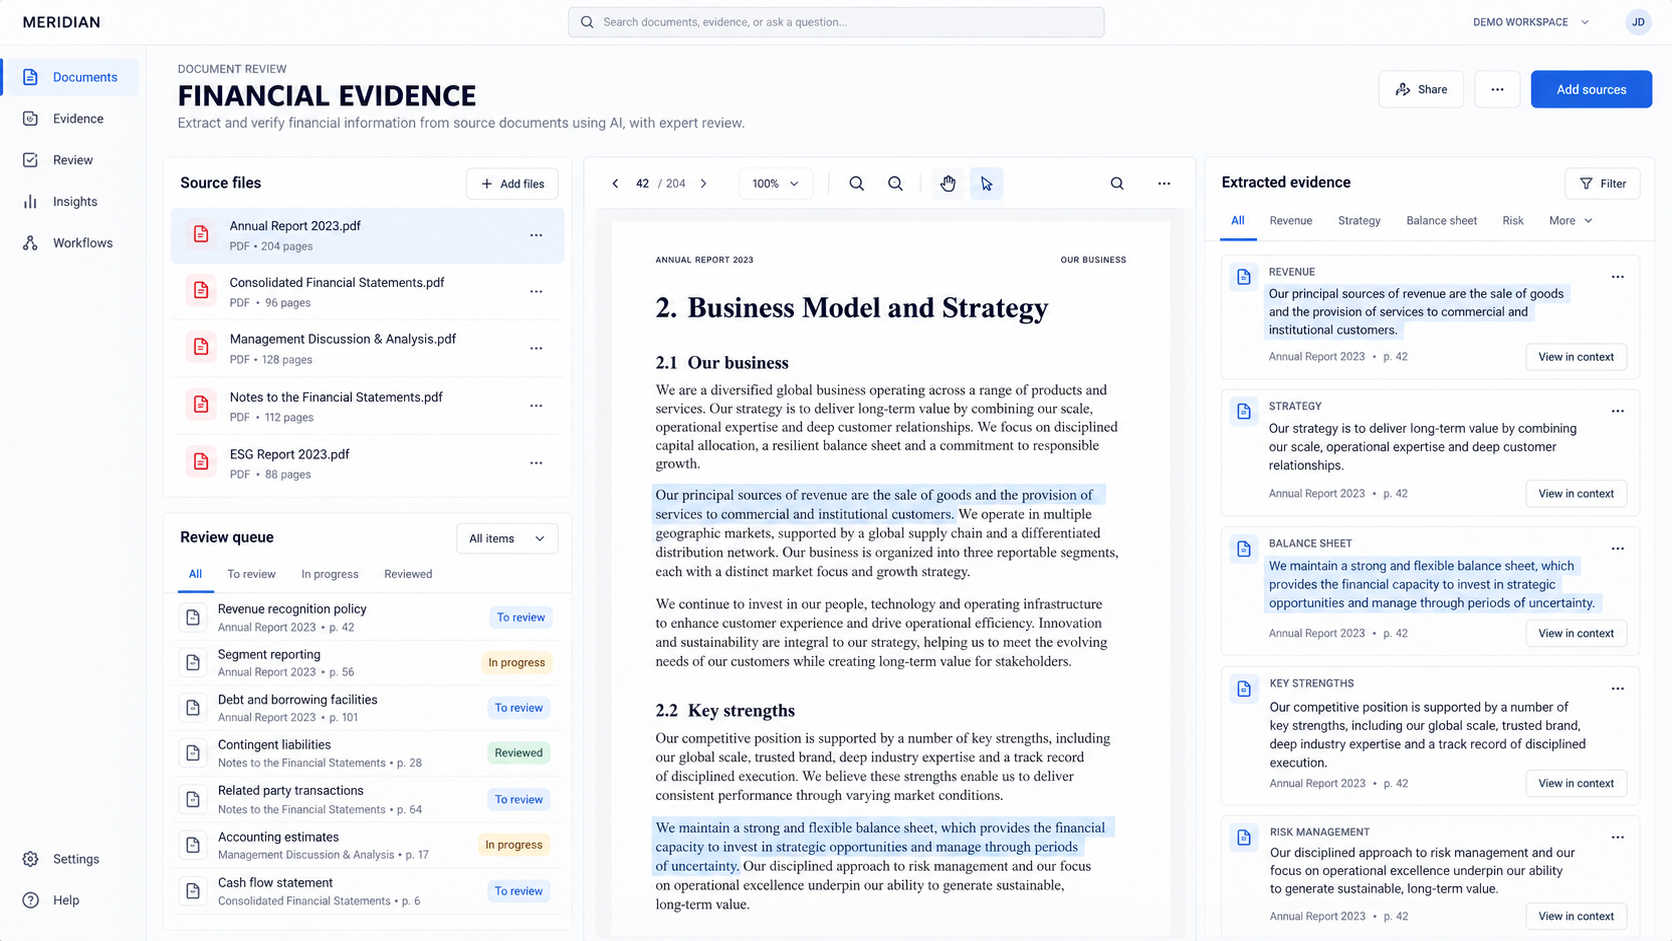
交付组织金融专家 × 来源证据 × 独立复核
金融长上下文推理与证据标注
让研究、估值、风控与合规判断同时保留答案、依据、边界与审核状态。
01跨年度、多来源长上下文与引用定位02结论、证据、反证与不确定边界一体交付03高风险分歧进入金融专家裁决记录
≈4.2K推理任务48–64K上下文>97%证据对齐
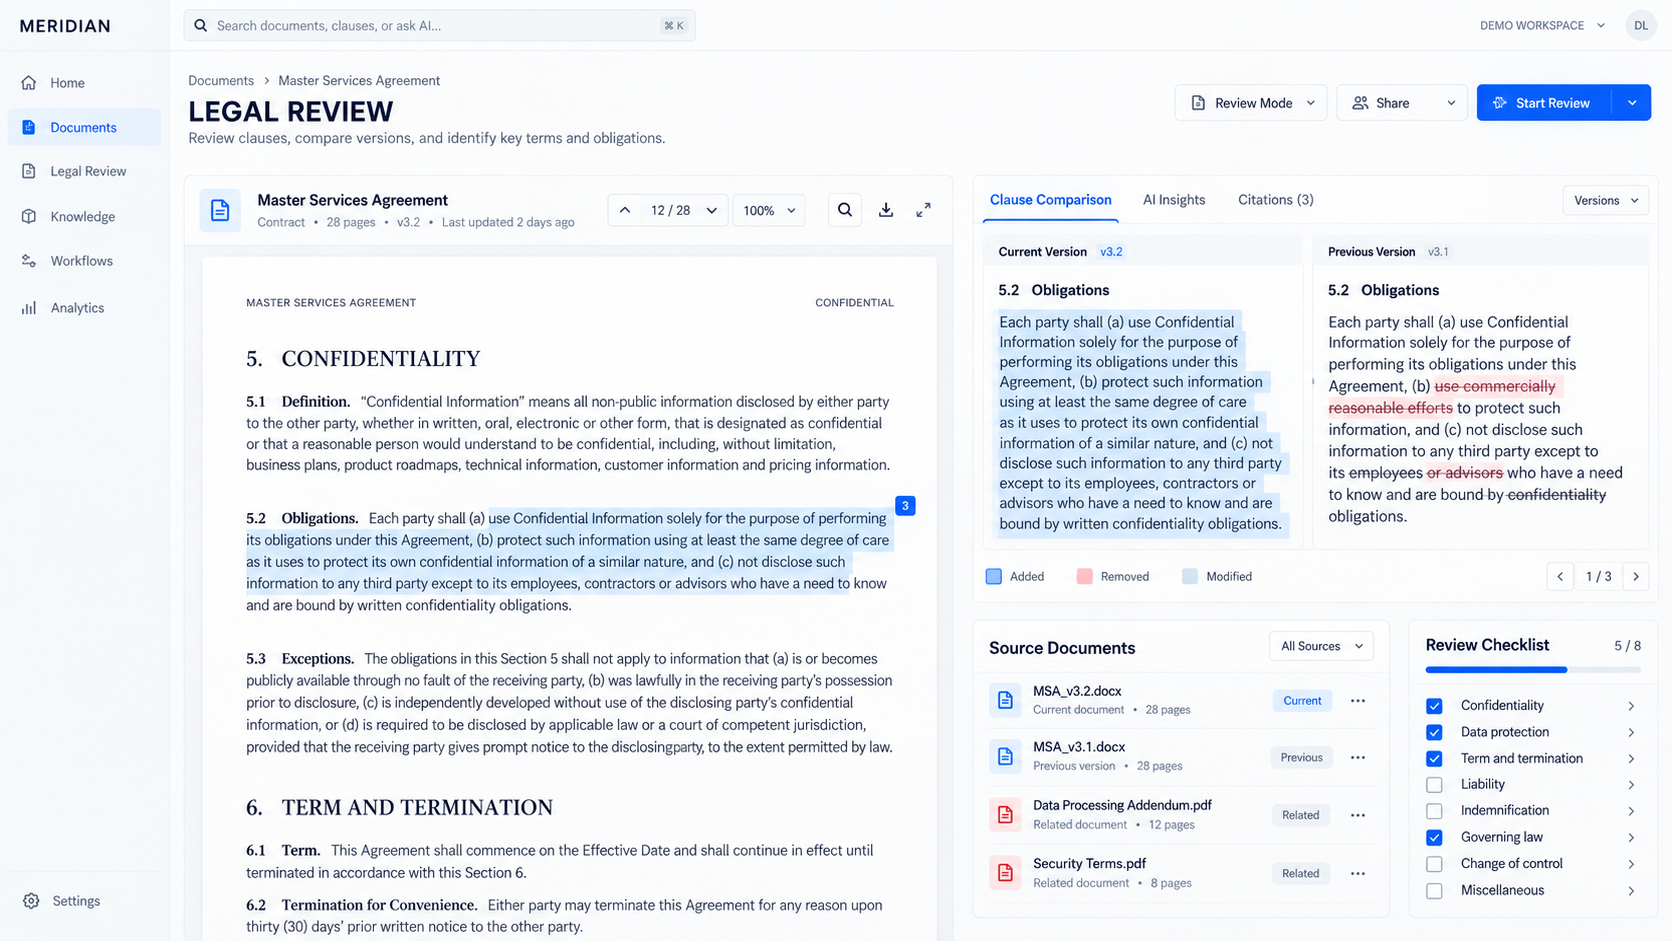
交付组织法域边界 × 引用级证据 × 盲审裁决
法律长文档审阅与引用级评测
围绕合同、法规与案件材料构建可验证任务,而不是只给出一个无出处的结论。
01合同、附件、法规与修订记录联合审阅02每个实质性主张绑定文本版本与引用跨度03专业分歧保留法域、理由与最终裁决
≈1.3K长文档任务3审阅层级>96%引用一致
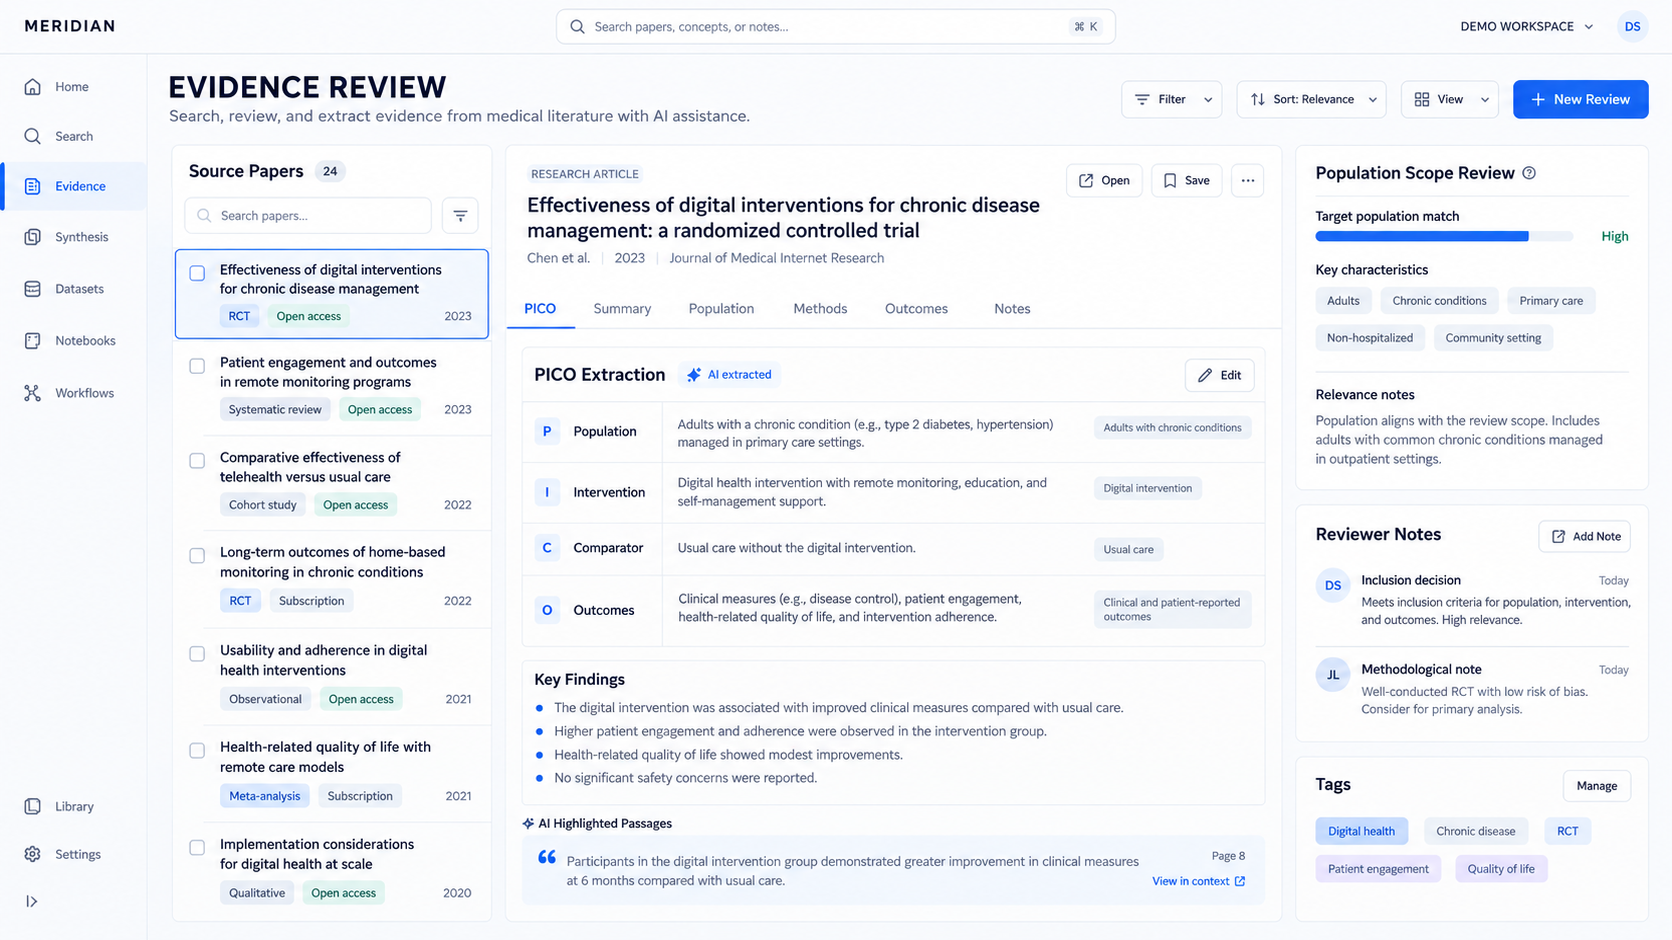
交付组织医学资格筛选 × 循证溯源 × 安全升级
医学证据抽取与安全边界评测
把文献、指南与病例型材料转化为结构化证据、参考答案和风险边界。
01研究人群、干预、结局与证据等级结构化02高风险结论执行双重医学复核03来源、置信度、安全边界与升级原因一并保留
≈3.6K证据单元2×医学复核0个人健康信息
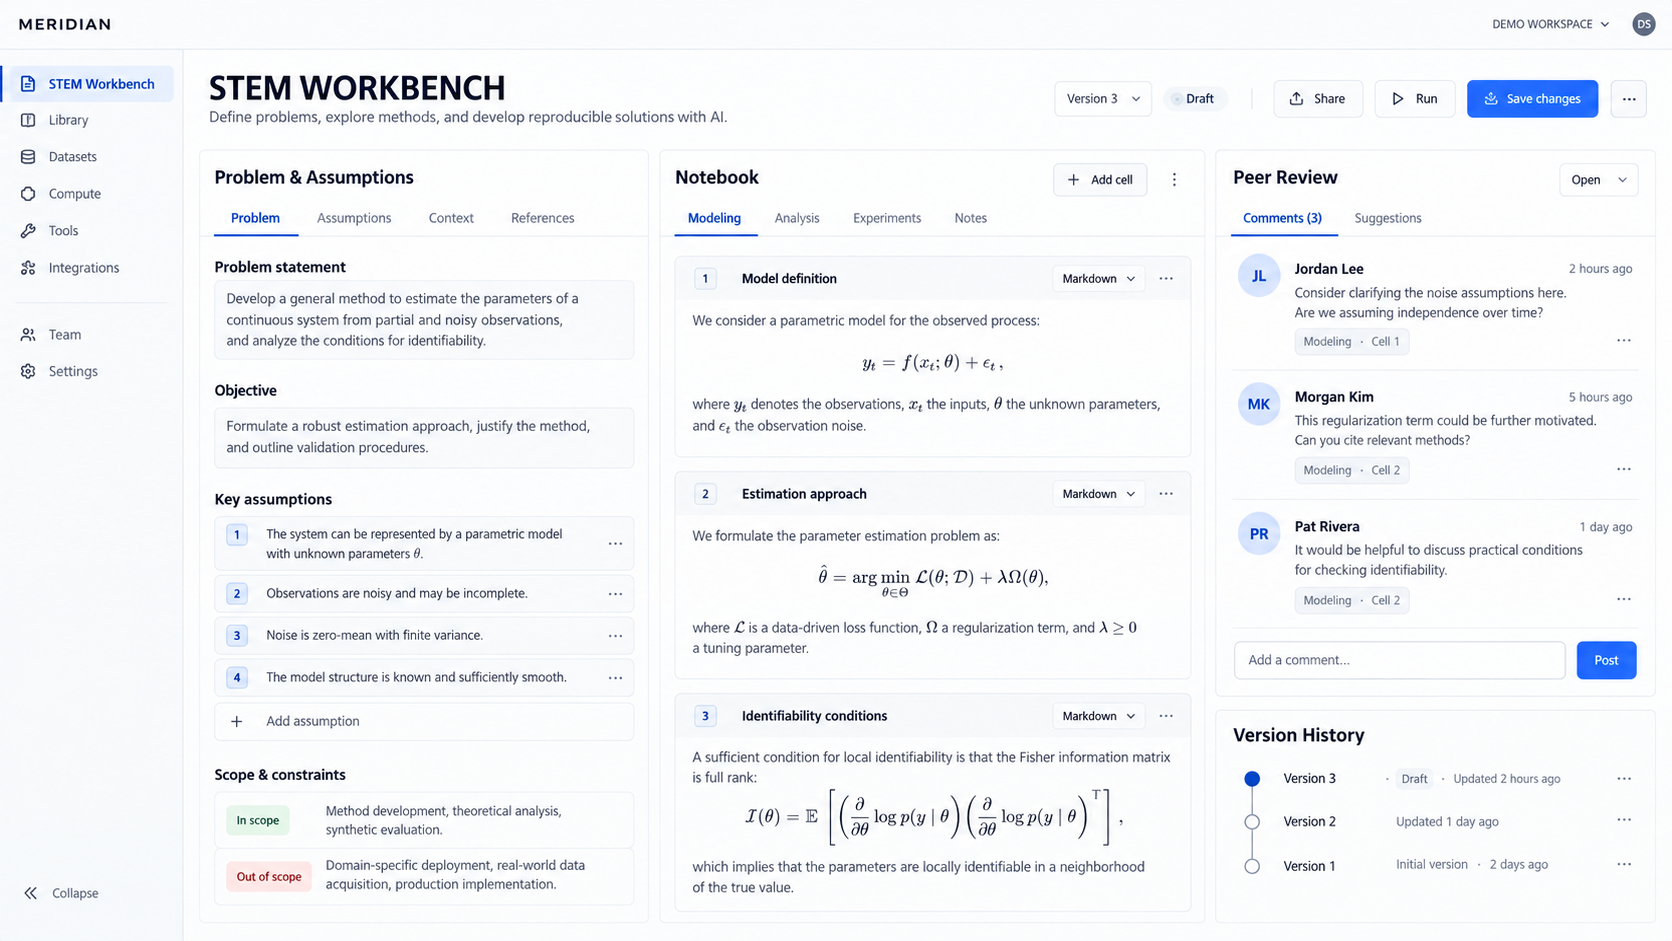
交付组织原创出题 × 参考解推导 × 验证器与难度校准
高难度 STEM Challenge Set 设计
把研究级知识、多步推导与可验证答案组织成模型无法靠检索直接解决的原创任务。
01跨数学、物理、化学、生物与计算机科学02题目、参考解、量规与验证器成套交付03独立复算、模型试跑与污染风险筛查
≈1.2K原创任务5STEM 领域6–18%模型通过率
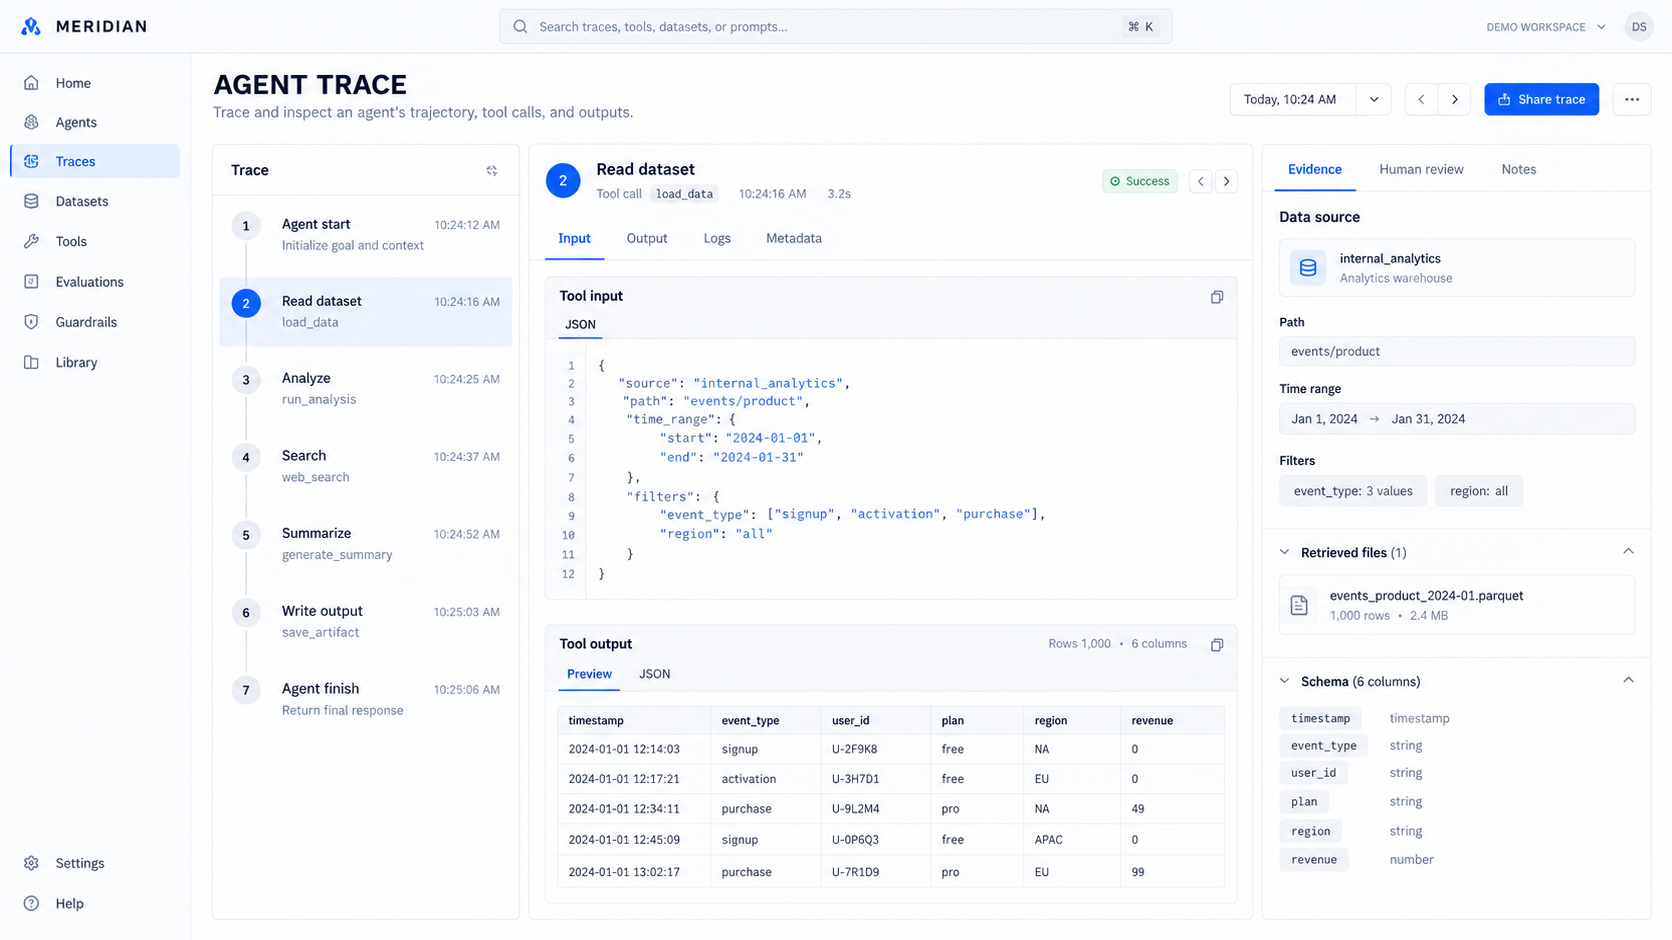
交付组织关键节点标注 × 双路审阅 × 失败分类
长程 Agent 轨迹与失败归因
从任务输入、计划与工具调用到最终交付物,逐节点审阅 Agent 行为。
01完整行动—观察—修正链路02过程质量与结果质量分离03失败原因对应可训练修正轨迹
≈2.8K长程轨迹18平均步骤7失败类型
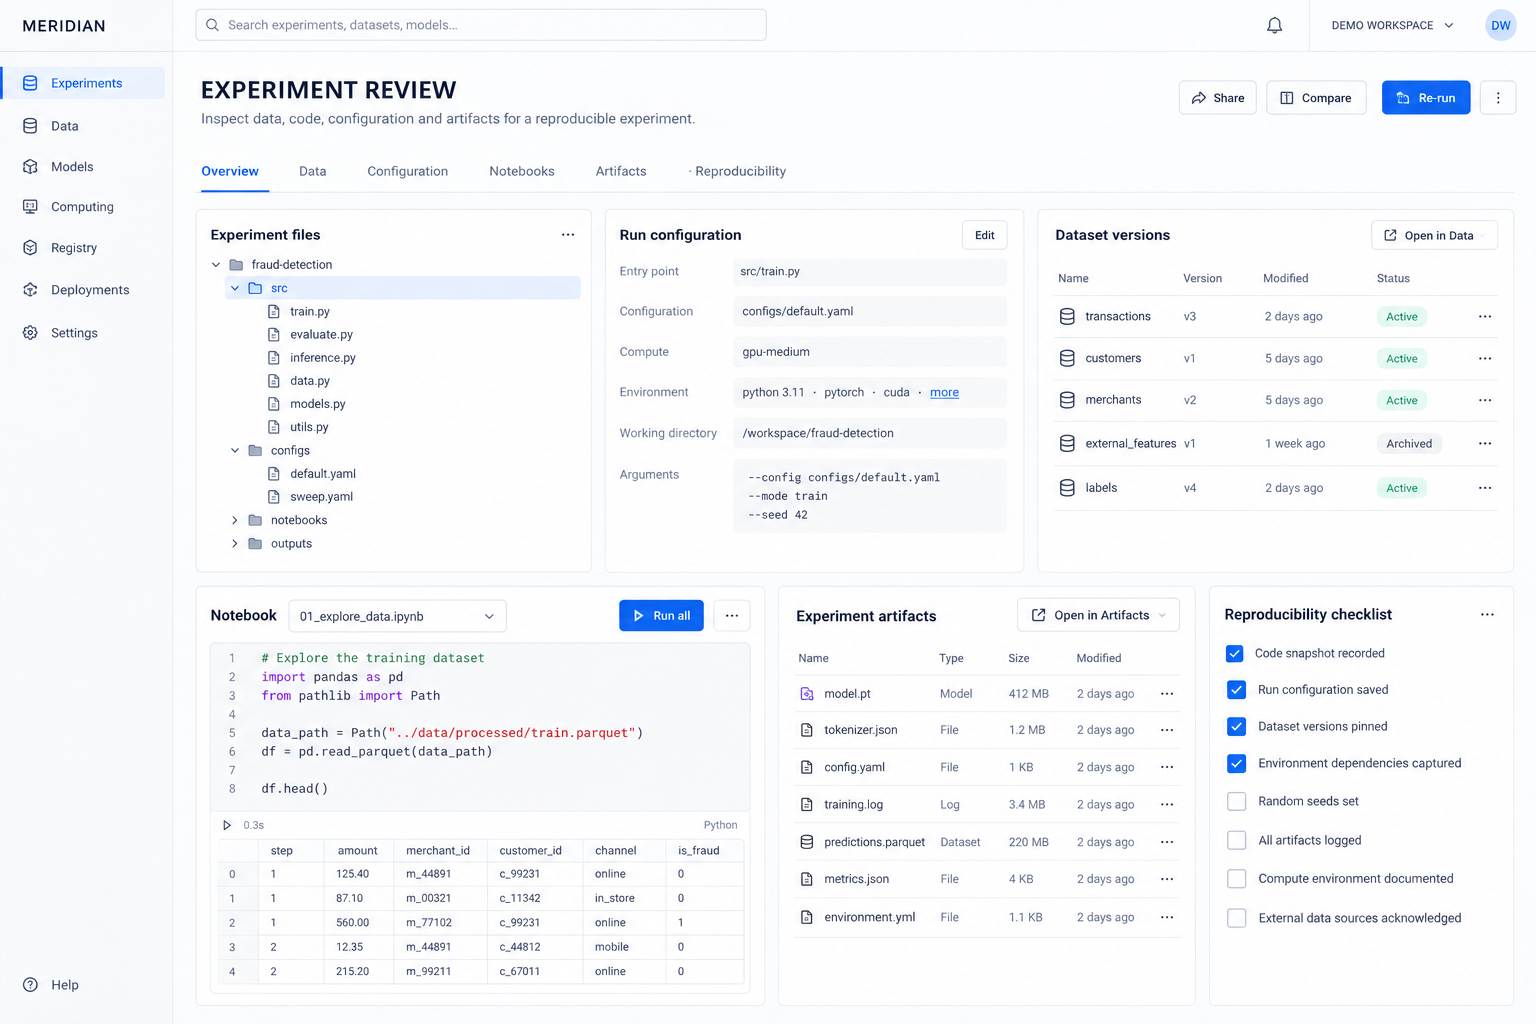
交付组织环境复现 × ML 专家审阅 × 独立复跑
MLE-Bench / MLS-Bench 型评测运营
从完成机器学习任务,进一步评估实验可复现性、方法改进与泛化证据。
01任务、环境、数据与评分器成套交付02实验记录和产物可追溯03工程完成度与科学有效性分层评测
420+实验运行3隔离环境>95%复跑一致
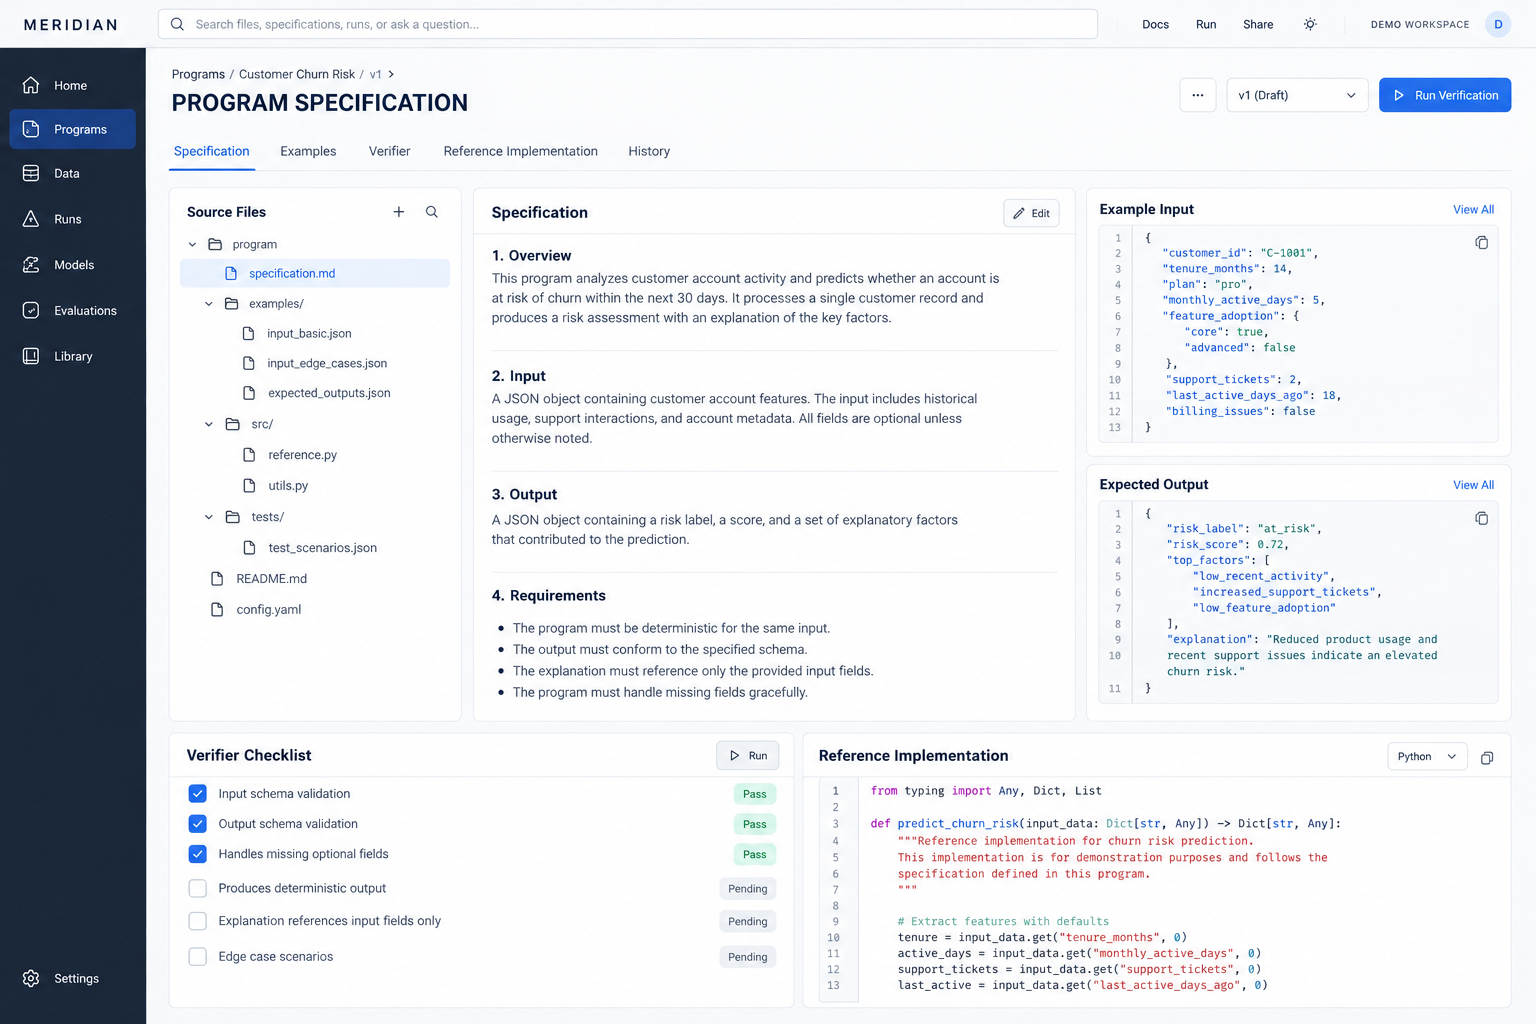
交付组织黑盒规格 × 隐藏测试 × 评分器复验
可执行程序行为重建评测
只给行为规格和黑盒参考,让模型重建完整、兼容且能通过隐藏测试的程序。
01从行为规格而非源代码重建完整程序02接口、状态、错误与边界测试组合03任务作者、验证工程师与评分器复验角色分离
360+程序任务26–140隐藏测试>98%评分稳定
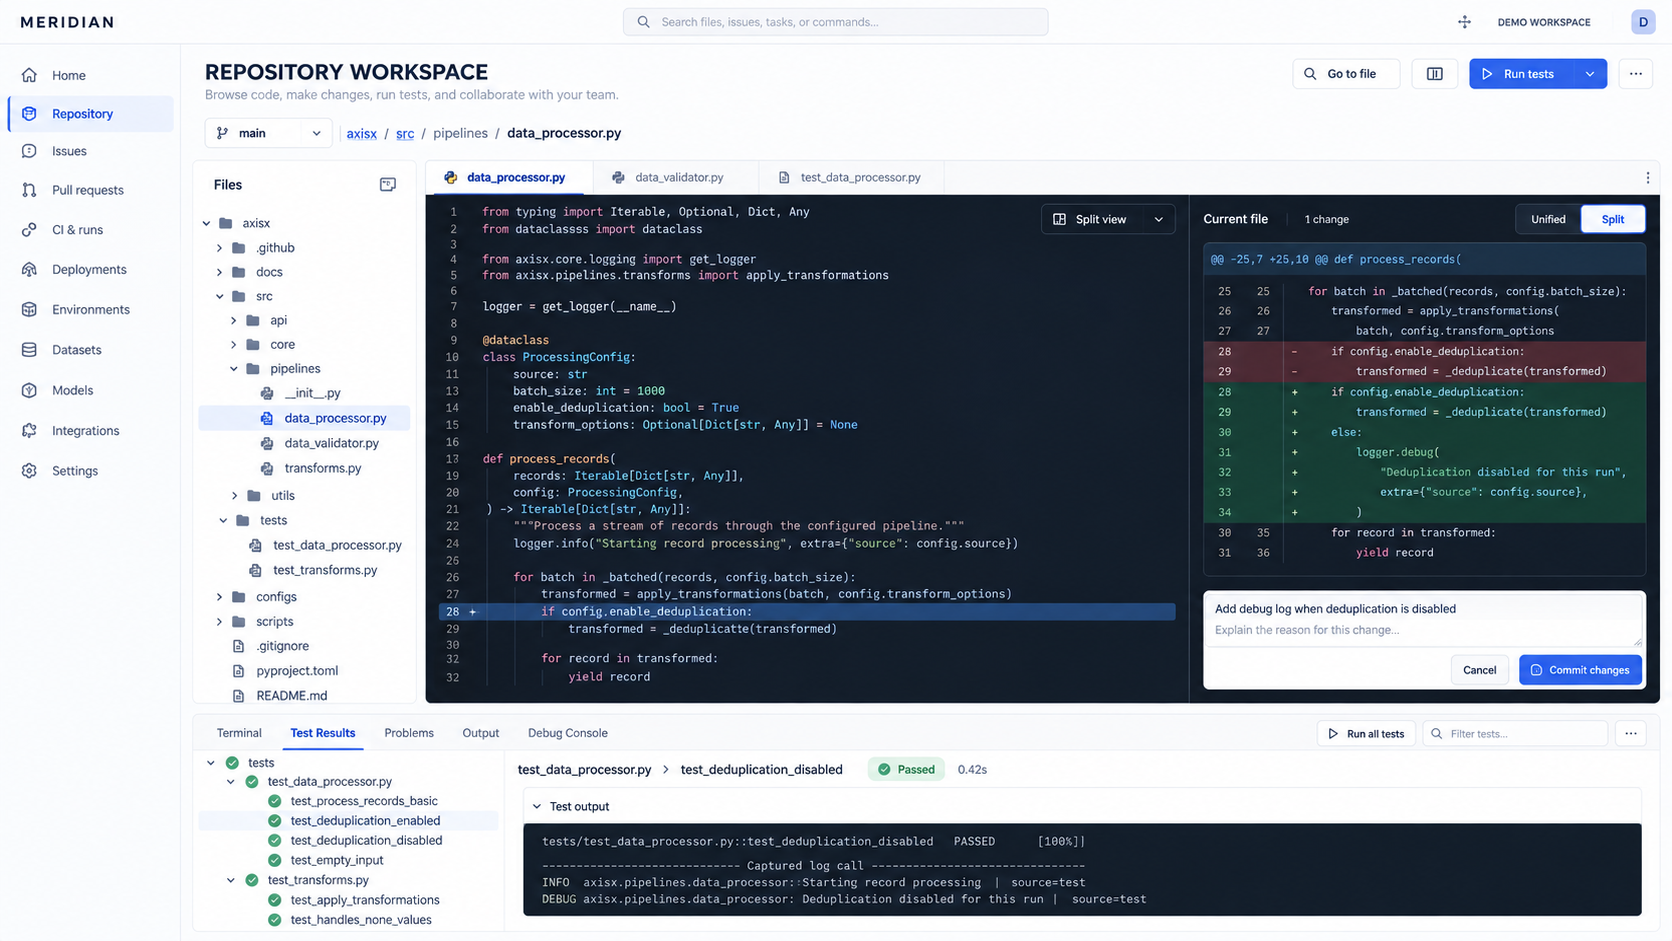
交付组织仓库快照 × 长程轨迹 × CI 验证
长程仓库级软件工程评测
把真实仓库探索、多文件实现、回归保护与环境验证组织成可裁决的长程任务。
01陌生仓库探索与多文件实现02补丁、测试、日志和回退轨迹联合验收03程序化验证器与独立工程审阅共同裁决
310+仓库任务2–14变更文件>96%CI 可复现
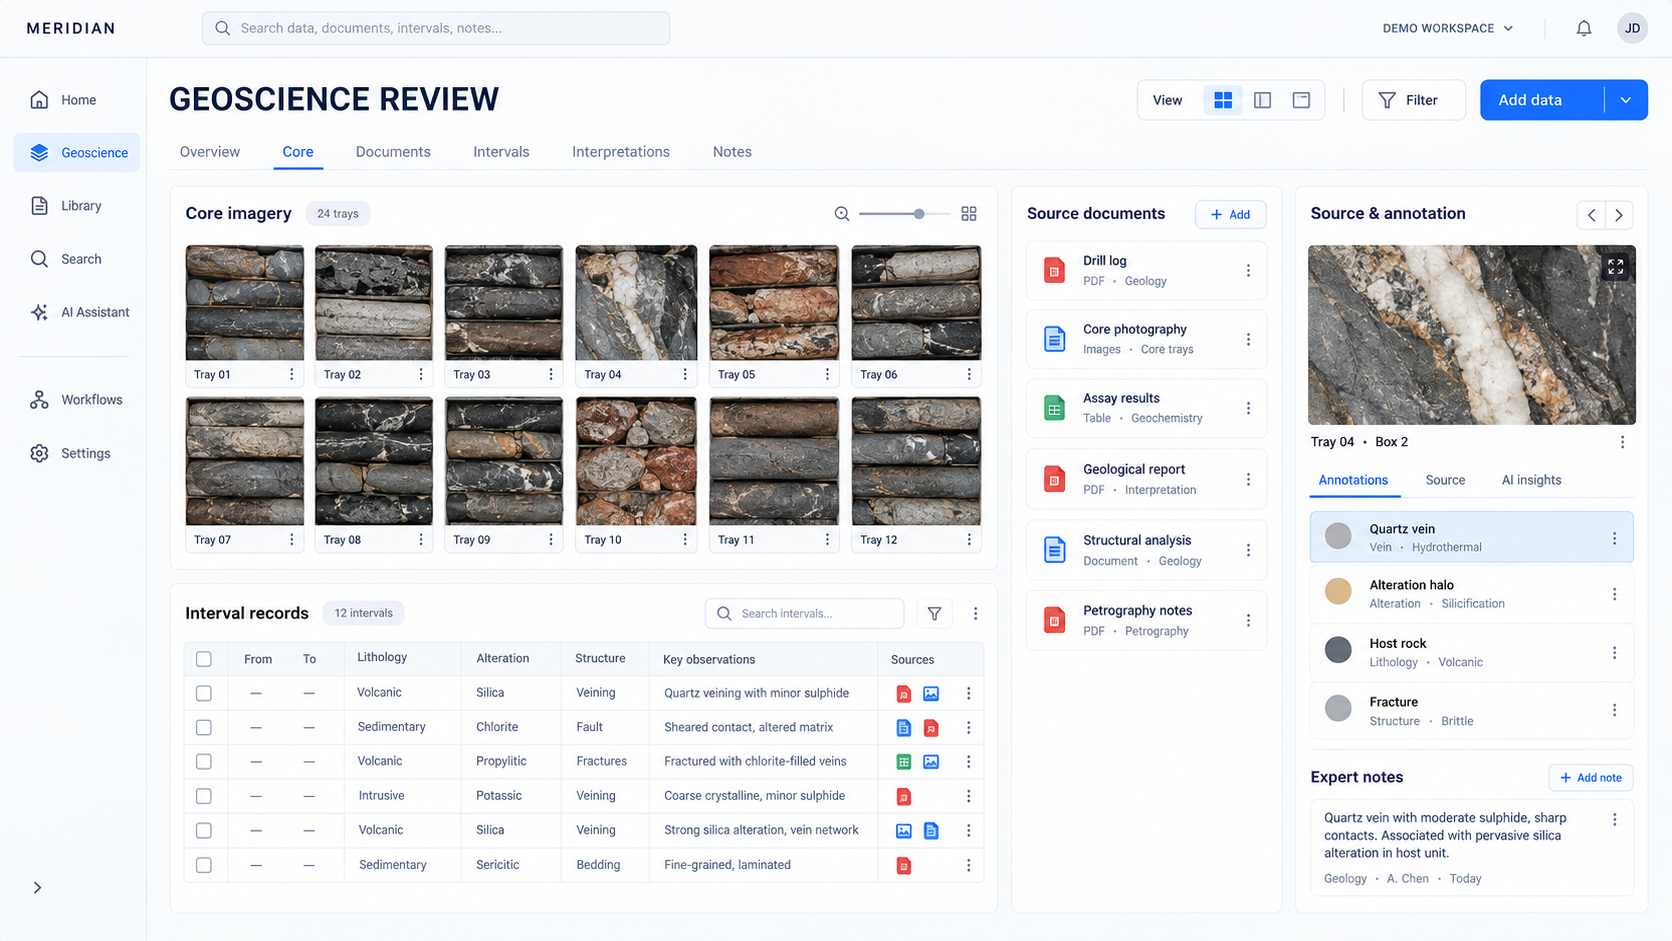
交付组织多源对齐 × 地学解释 × 专家复核
地质多源资料解释与证据合成
把井、层、图、报告与历史解释连接为可追溯的专业判断任务。
01测井、岩芯、层位、图件与报告联合对齐02结论绑定深度区间、来源版本与不确定性03高影响解释执行独立地学复核
720+解释任务5来源类型>96%来源链完整
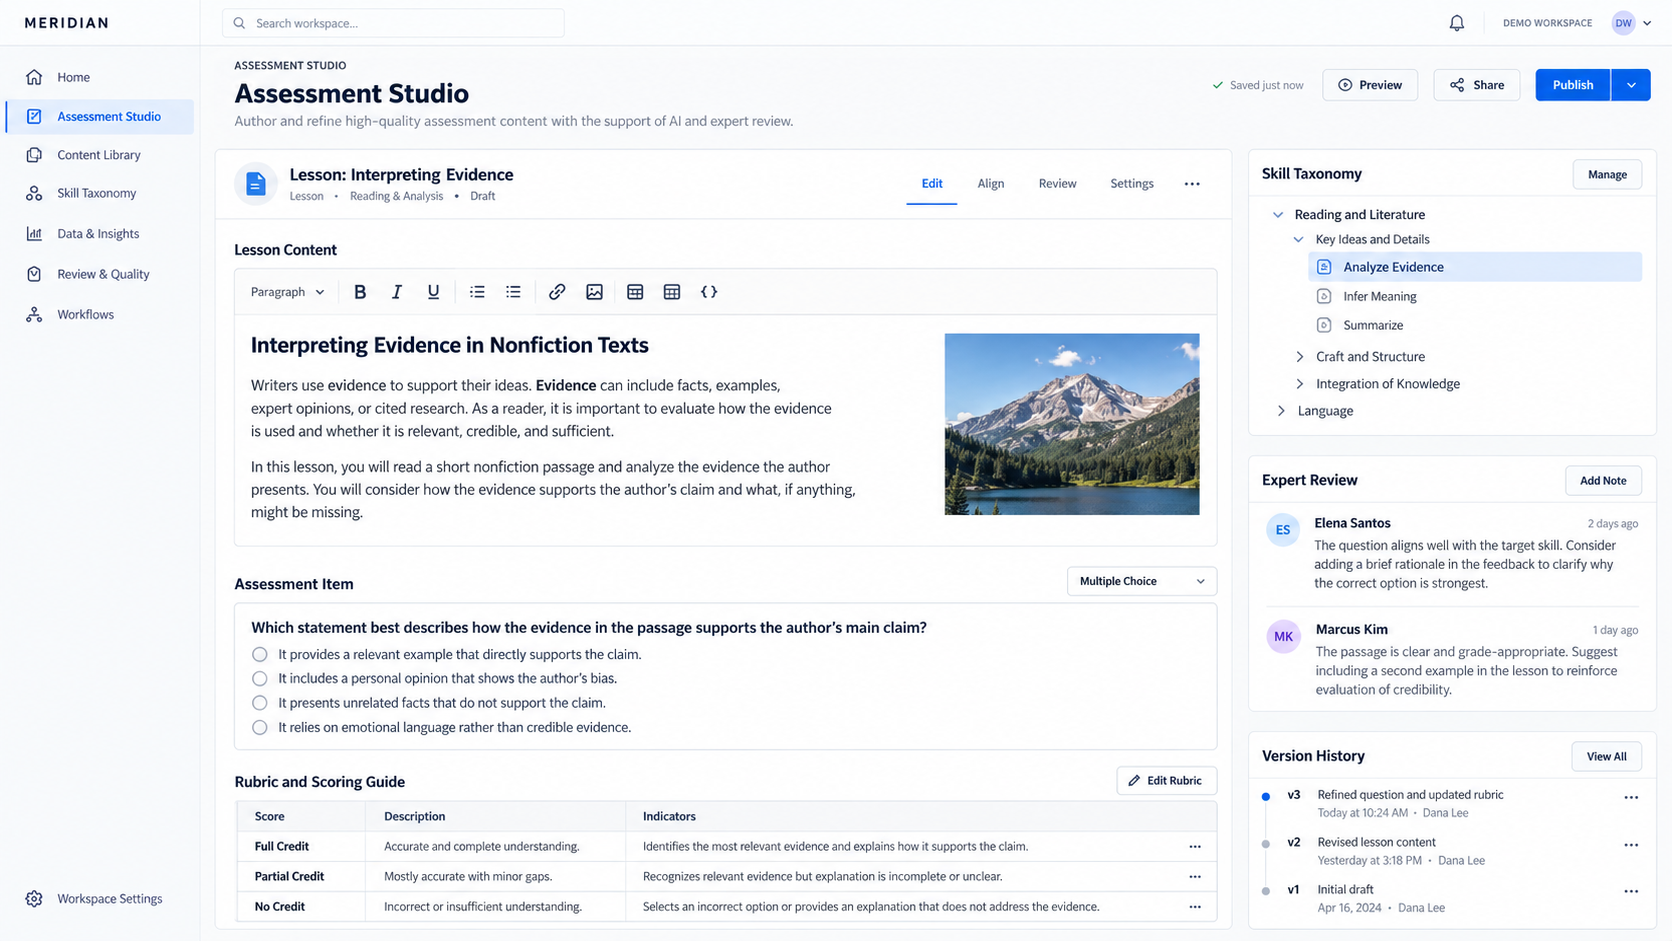
交付组织课程对齐 × 原创题目 × 难度校准
课程知识、原创题目与学习诊断评测
把课程标准、知识点依赖、原创题目和可解释评分组织成可靠的教育模型数据。
01课程标准、知识点依赖与题目能力目标对齐02参考解、步骤量规与典型误区成套交付03教师复算、模型试跑与难度偏差校准
1.6K+评测任务6难度层级>93%量规一致
案例采用代表性脱敏交付结构:客户身份、输入内容及部分规模指标已移除或区间化,仅用于说明项目方法与既有交付经验,不构成对未来结果的承诺。
让下一批数据,针对你的能力目标
从任务目标与样例开始,共同确定材料、专家、验证方法与交付范围。